 Cyber RoadmapINDONESIA
Fondasi · Fase 1
Python requests: GET dan POST ke API serta Scraping Dasar yang Etis
Ajari Python berbicara dengan web. Pelajari cara memasang requests dengan aman, mengirim GET dan POST, membaca kode status dan header, memakai kunci API tanpa membocorkannya, scraping dasar dengan BeautifulSoup beserta etikanya, lalu membuat alat pemeriksa header keamanan situs.

Di dua artikel sebelumnya, skrip Python kita hanya mengolah file di komputer sendiri. Sekarang kita buka jendelanya ke luar: Python akan mengirim permintaan ke server web, membaca jawabannya, dan mengambil data dari halaman web.
Alat yang paling populer untuk itu adalah pustaka requests. Dengan beberapa baris kode, kamu bisa memanggil API, mengirim data formulir, sampai mengambil isi halaman web. Di dunia keamanan siber, kemampuan ini dipakai untuk banyak hal: mengecek reputasi alamat IP lewat API threat intelligence, memeriksa konfigurasi keamanan situs, mengotomatiskan pengujian aplikasi web, sampai mengumpulkan informasi publik dalam OSINT.
Semua komunikasi di artikel ini memakai HTTP dan HTTPS. Kalau kamu ingin mengingat lagi cara kerja dan bedanya, baca dulu artikel HTTP vs HTTPS di Fase 0.
Memasang requests dengan aman
Pustaka requests bukan modul bawaan, jadi perlu dipasang dulu. Di Ubuntu dan Debian versi baru, perintah pip install langsung ke sistem akan ditolak supaya tidak merusak paket bawaan. Cara yang benar adalah membuat virtual environment, yaitu folder terpisah khusus untuk pustaka proyekmu.
python3 -m venv venv              # buat lingkungan terpisah bernama venv
source venv/bin/activate          # aktifkan (di Windows: venv\Scripts\activate)
pip install requests beautifulsoup4
python3 -c "import requests; print(requests.__version__)"
Setiap kali membuka terminal baru, aktifkan lagi dengan source venv/bin/activate. Tanda (venv) di awal prompt menandakan lingkungannya aktif.
Request dan response
Setiap komunikasi dengan server web terdiri dari dua bagian: request yang kamu kirim dan response yang dikirim balik oleh server.
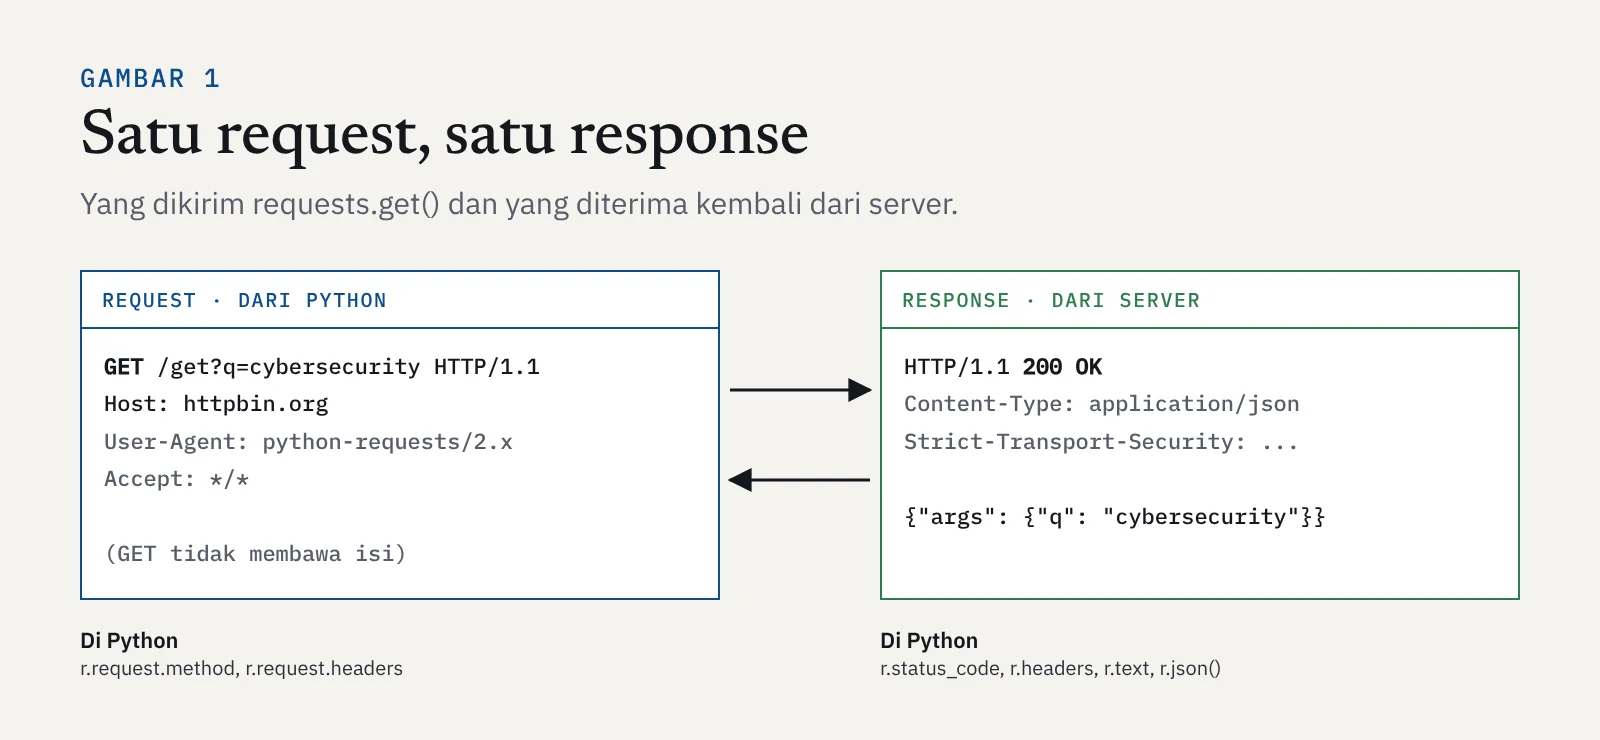
Untuk latihan, kita memakai httpbin.org, layanan yang memang dibuat untuk menguji permintaan HTTP. Ia akan memantulkan kembali apa yang kamu kirim, sehingga kamu bisa melihat isinya.
GET: meminta data
import requests

r = requests.get(
    "https://httpbin.org/get",
    params={"q": "cybersecurity", "halaman": 2},
    timeout=10,
)
print(r.status_code)                   # 200
print(r.headers["Content-Type"])       # application/json
data = r.json()                        # ubah jawaban JSON menjadi dictionary
print(data["args"])                    # {'q': 'cybersecurity', 'halaman': '2'}
Parameter params otomatis diubah menjadi bagian alamat, yaitu ?q=cybersecurity&halaman=2. Banyak API mengirim jawaban dalam format JSON, dan r.json() langsung mengubahnya menjadi dictionary Python yang sudah kamu kenal.
POST: mengirim data
import requests

# mengirim data dalam format JSON, umum dipakai API
r = requests.post("https://httpbin.org/post", json={"user": "budi", "aksi": "uji"}, timeout=10)
print(r.json()["json"])                # {'user': 'budi', 'aksi': 'uji'}

# mengirim data seperti formulir di halaman web
r = requests.post("https://httpbin.org/post", data={"user": "budi"}, timeout=10)
print(r.json()["form"])                # {'user': 'budi'}
Bedanya penting: json= mengirim data sebagai JSON, cocok untuk API modern. data= mengirim data seperti formulir login di halaman web.
Membaca kode status dan menangani error
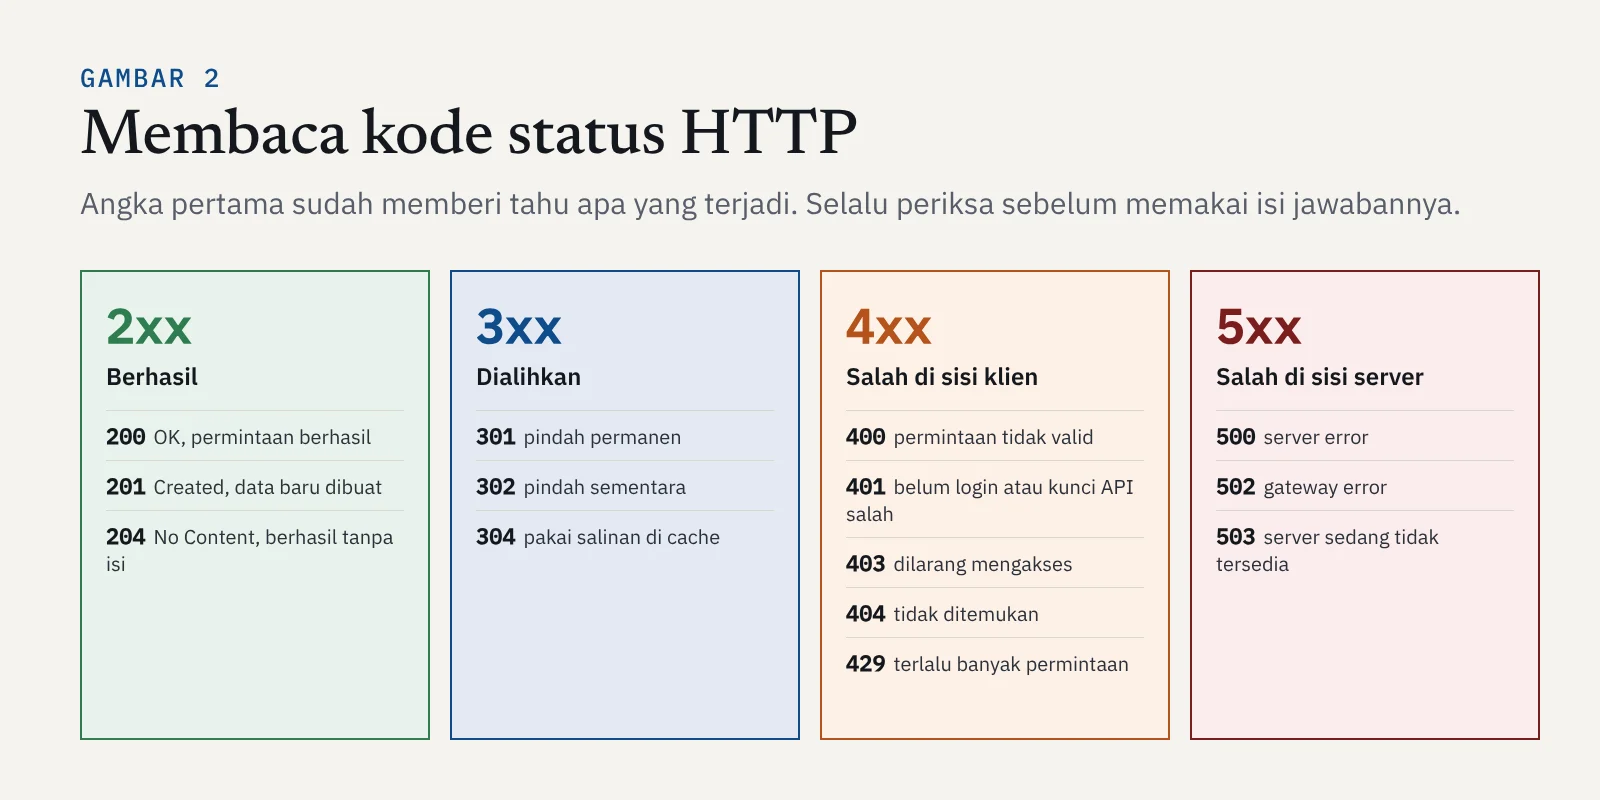
Sebelum memakai isi jawaban, periksa dulu kode statusnya. Jangan berasumsi permintaanmu selalu berhasil.
import requests

try:
    r = requests.get("https://httpbin.org/status/404", timeout=10)
    r.raise_for_status()               # memunculkan error kalau status 4xx atau 5xx
except requests.exceptions.HTTPError as e:
    print("Server menolak:", e.response.status_code)
except requests.exceptions.Timeout:
    print("Server terlalu lama menjawab")
except requests.exceptions.ConnectionError:
    print("Tidak bisa tersambung ke server")
Kode 429 perlu diperhatikan khusus. Artinya kamu mengirim permintaan terlalu cepat dan server mulai membatasi. Kalau ini muncul, perlambat skripmu.
Header: identitas permintaanmu
Setiap request membawa header, informasi tambahan tentang permintaan. Salah satunya User-Agent, yang memberi tahu server program apa yang mengirim permintaan. Biasakan memberi nama yang jujur agar pemilik server tahu siapa yang mengakses.
import requests

HEADERS = {"User-Agent": "BelajarKeamanan/1.0 (latihan pribadi)"}
r = requests.get("https://httpbin.org/get", headers=HEADERS, timeout=10)
print(r.json()["headers"]["User-Agent"]) # BelajarKeamanan/1.0 (latihan pribadi)| Atribut | Isinya |
|---|---|
r.status_code | Kode status, misalnya 200 atau 404 |
r.headers | Header dari server, bisa dibaca seperti dictionary |
r.text | Isi jawaban sebagai teks, misalnya HTML |
r.json() | Isi jawaban JSON yang diubah menjadi dictionary |
r.url | Alamat akhir setelah semua pengalihan |
r.cookies | Cookie yang dikirim server, seperti di artikel Browser, Cookie, dan Cache |
Memakai API yang butuh kunci
Banyak API, termasuk layanan threat intelligence untuk mengecek reputasi alamat IP atau file, meminta kunci API (API key). Kunci ini seperti password: siapa pun yang memegangnya bisa memakai kuotamu atas namamu.
import os
import requests

API_KEY = os.environ.get("API_KEY_SAYA")       # ambil dari variabel lingkungan
if not API_KEY:
    raise SystemExit("Set dulu: export API_KEY_SAYA=isi-kunci-kamu")

r = requests.get(
    "https://api.contoh.id/v1/cek-ip",
    params={"ip": "203.0.113.7"},
    headers={"Authorization": f"Bearer {API_KEY}"},
    timeout=10,
)
Alamat API di atas hanya contoh. Setiap layanan punya alamat dan cara mengirim kunci yang berbeda, jadi selalu baca dokumentasinya.
Scraping dasar dengan BeautifulSoup
Tidak semua data tersedia lewat API. Kadang data hanya ada di halaman web. Mengambil data dari halaman web secara otomatis disebut scraping. requests mengambil HTML-nya, lalu pustaka BeautifulSoup membantu mencari bagian yang kita butuhkan.
Tapi sebelum mulai, ada aturan mainnya.
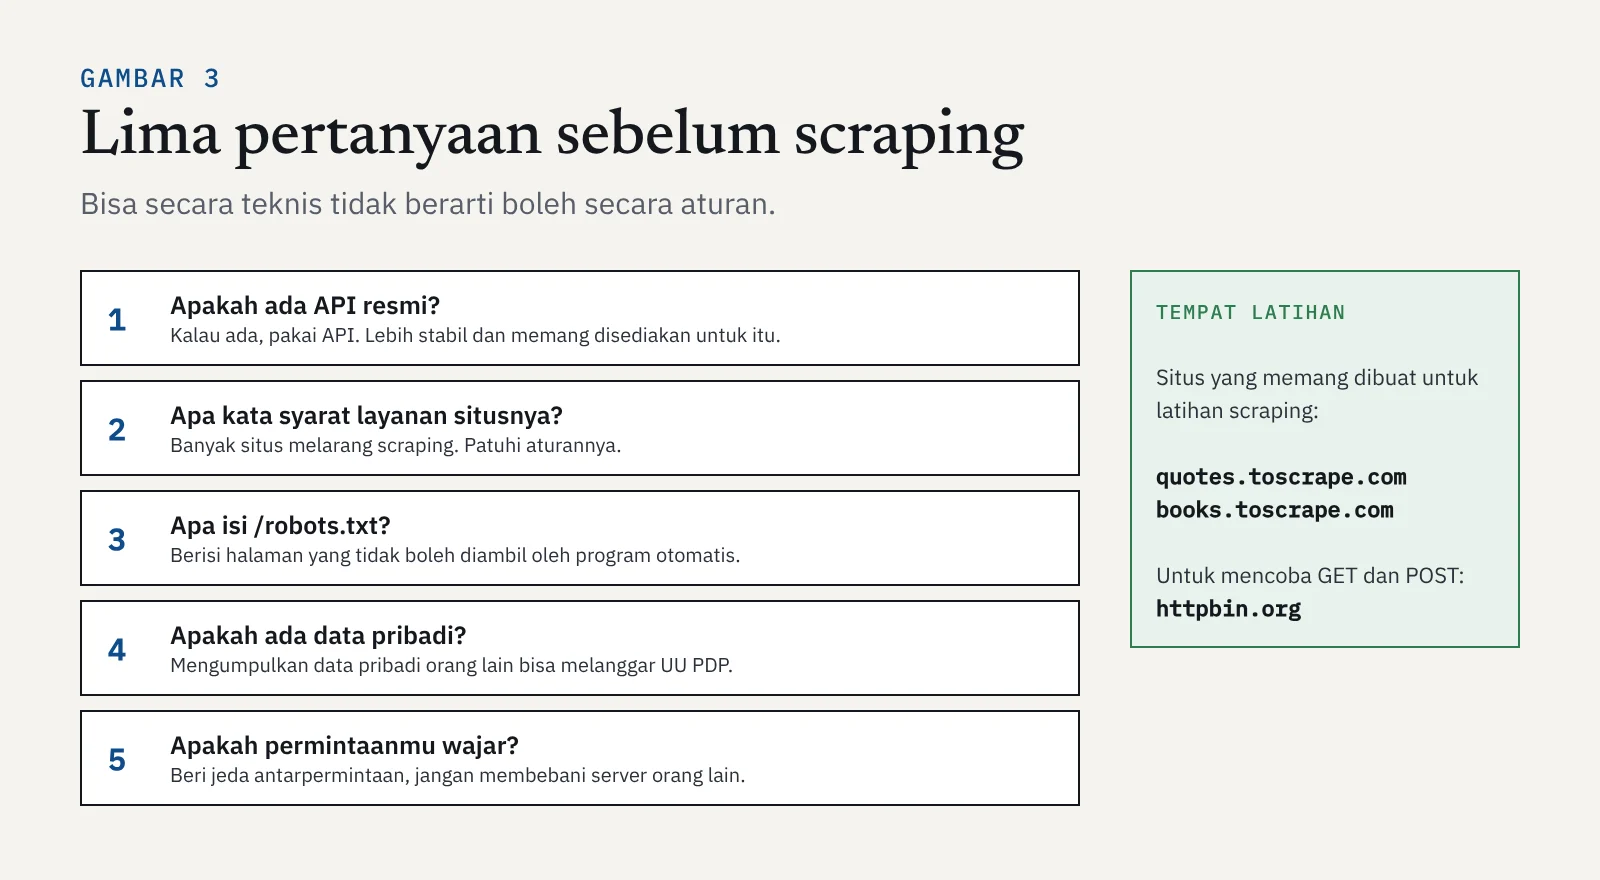
Contoh di bawah memakai quotes.toscrape.com, situs yang memang dibuat untuk latihan scraping.
# scrape_quotes.py - contoh scraping di situs yang memang dibuat untuk latihan
import time
import requests
from bs4 import BeautifulSoup

URL = "https://quotes.toscrape.com/"
HEADERS = {"User-Agent": "BelajarKeamanan/1.0 (latihan pribadi)"}

r = requests.get(URL, headers=HEADERS, timeout=10)
r.raise_for_status()
soup = BeautifulSoup(r.text, "html.parser")

for kutipan in soup.select("div.quote"):
    teks = kutipan.select_one("span.text").get_text(strip=True)
    penulis = kutipan.select_one("small.author").get_text(strip=True)
    tag = [a.get_text() for a in kutipan.select("a.tag")]
    print(f"{penulis}: {teks[:50]}... {tag}")

berikutnya = soup.select_one("li.next a")
if berikutnya:
    print("Halaman berikutnya:", berikutnya["href"])
time.sleep(1)  # beri jeda sebelum permintaan berikutnya
python3 scrape_quotes.py
# Albert Einstein: “The world as we have created it is a process of o... ['change', 'thinking']
# ...
# Halaman berikutnya: /page/2/Cara mencari bagiannya sama dengan selector CSS. select("div.quote") mencari semua elemen div berkelas quote. Untuk tahu nama elemen dan kelasnya, buka halaman di browser, klik kanan pada bagian yang diinginkan, lalu pilih Inspect.
| Fungsi | Kegunaan |
|---|---|
soup.select("selector") | Semua elemen yang cocok, dalam bentuk list |
soup.select_one("selector") | Elemen pertama yang cocok, atau None |
elemen.get_text(strip=True) | Teks di dalam elemen, tanpa spasi berlebih |
elemen["href"] | Nilai atribut, misalnya alamat tautan |
soup.find_all("a") | Semua elemen dengan tag tertentu |
Proyek: pemeriksa header keamanan situs
Sekarang kita buat alat kecil yang berguna. Server web yang baik mengirim beberapa header keamanan untuk memerintahkan browser berperilaku lebih aman. Skrip berikut memeriksa header mana yang ada dan mana yang belum. Pemeriksaan ini hanya mengirim satu permintaan biasa, sama seperti saat kamu membuka situs di browser.
# cek_header.py - memeriksa header keamanan sebuah situs web
import sys
import requests

HEADER_PENTING = {
    "Strict-Transport-Security": "memaksa browser selalu memakai HTTPS",
    "Content-Security-Policy": "membatasi sumber skrip untuk mencegah XSS",
    "X-Content-Type-Options": "mencegah browser menebak jenis file",
    "X-Frame-Options": "mencegah situs dimuat di dalam frame (clickjacking)",
    "Referrer-Policy": "membatasi informasi alamat asal yang dibagikan",
}


def periksa(url):
    try:
        r = requests.get(url, timeout=10, headers={"User-Agent": "CekHeader/1.0"})
    except requests.exceptions.RequestException as e:
        print(f"Gagal menghubungi {url}: {e}")
        return

    print(f"{url} -> status {r.status_code}")
    ada = 0
    for nama, fungsi in HEADER_PENTING.items():
        if nama in r.headers:
            ada += 1
            print(f"  [ADA]   {nama}")
        else:
            print(f"  [TIDAK] {nama} ({fungsi})")

    if "Server" in r.headers:
        print(f"  Info: server mengaku sebagai '{r.headers['Server']}'")
    print(f"Skor: {ada} dari {len(HEADER_PENTING)} header keamanan")


if __name__ == "__main__":
periksa(sys.argv[1] if len(sys.argv) > 1 else "https://example.com")Kenapa ini penting untuk keamanan siber
Hampir semua layanan keamanan modern, dari threat intelligence, pemindai kerentanan, sampai SIEM, menyediakan API. Dengan requests, kamu bisa menghubungkan alat-alat itu dan mengotomatiskan pekerjaan yang tadinya manual, misalnya mengecek reputasi semua alamat IP dari hasil analisis log di artikel sebelumnya. Di sisi pengujian, banyak celah aplikasi web ditemukan dengan mengirim permintaan yang dimodifikasi secara terprogram. Memahami cara Python berbicara dengan web adalah dasar dari semua itu.
Ringkasan
- Pasang
requestsdi virtual environment, dan periksa ejaan nama pustaka. requests.get()meminta data,requests.post()mengirim data denganjson=ataudata=.- Selalu pakai
timeout, periksa kode status, dan tangani error dengantrydanexcept. - Simpan kunci API di variabel lingkungan, jangan di dalam kode, dan jangan pernah memakai
verify=False. - BeautifulSoup membantu mengambil bagian halaman web dengan selector CSS.
- Sebelum scraping, cek API resmi, syarat layanan, robots.txt, data pribadi, dan beri jeda antarpermintaan.
Tonton dan baca juga
- Video: Web Scraping
- Artikel: Membuat web scraper dengan Python
- Dokumentasi resmi requests (bahasa Inggris)
Materi berikutnya pindah ke Bash, bahasa skrip bawaan terminal Linux: variabel, loop, kondisi, pipe, redirect, dan menjadwalkan tugas dengan cron. Buka di roadmap untuk melanjutkan.


