 Cyber RoadmapINDONESIA
Riset
Skor Nyaris Seragam: Masih Bisakah Datanya Dipercaya? Membedah Ceiling Effect dalam Disertasi
Apa itu ceiling effect, kenapa skor survei tata kelola keamanan bisa menumpuk di batas atas, bukti bahwa struktur hubungan antarvariabel tetap utuh, akibatnya pada IPMA, serta cara menjawab pertanyaan penguji dengan pola akui, jelaskan, buktikan, tangani.
Ada satu temuan di disertasi saya yang hampir pasti dikejar penguji, terutama penguji yang kuat di statistik: hampir semua responden memberi skor sangat tinggi, dan skornya nyaris seragam. Pertanyaannya pun bisa tajam: "Kalau semua orang menjawab hampir sama, apa datanya masih bisa dipercaya? Jangan-jangan responden hanya menjawab yang ideal?"
Gejala ini disebut ceiling effect. Artikel ini membedahnya: apa itu, kenapa bisa terjadi, bukti apa yang menunjukkan hasil penelitian tetap bisa dipegang, dan bagaimana menjawabnya dengan jujur tanpa terdengar defensif. Gambaran umum disertasinya ada di Disertasi Saya dalam 5 Menit.
Apa itu ceiling effect?
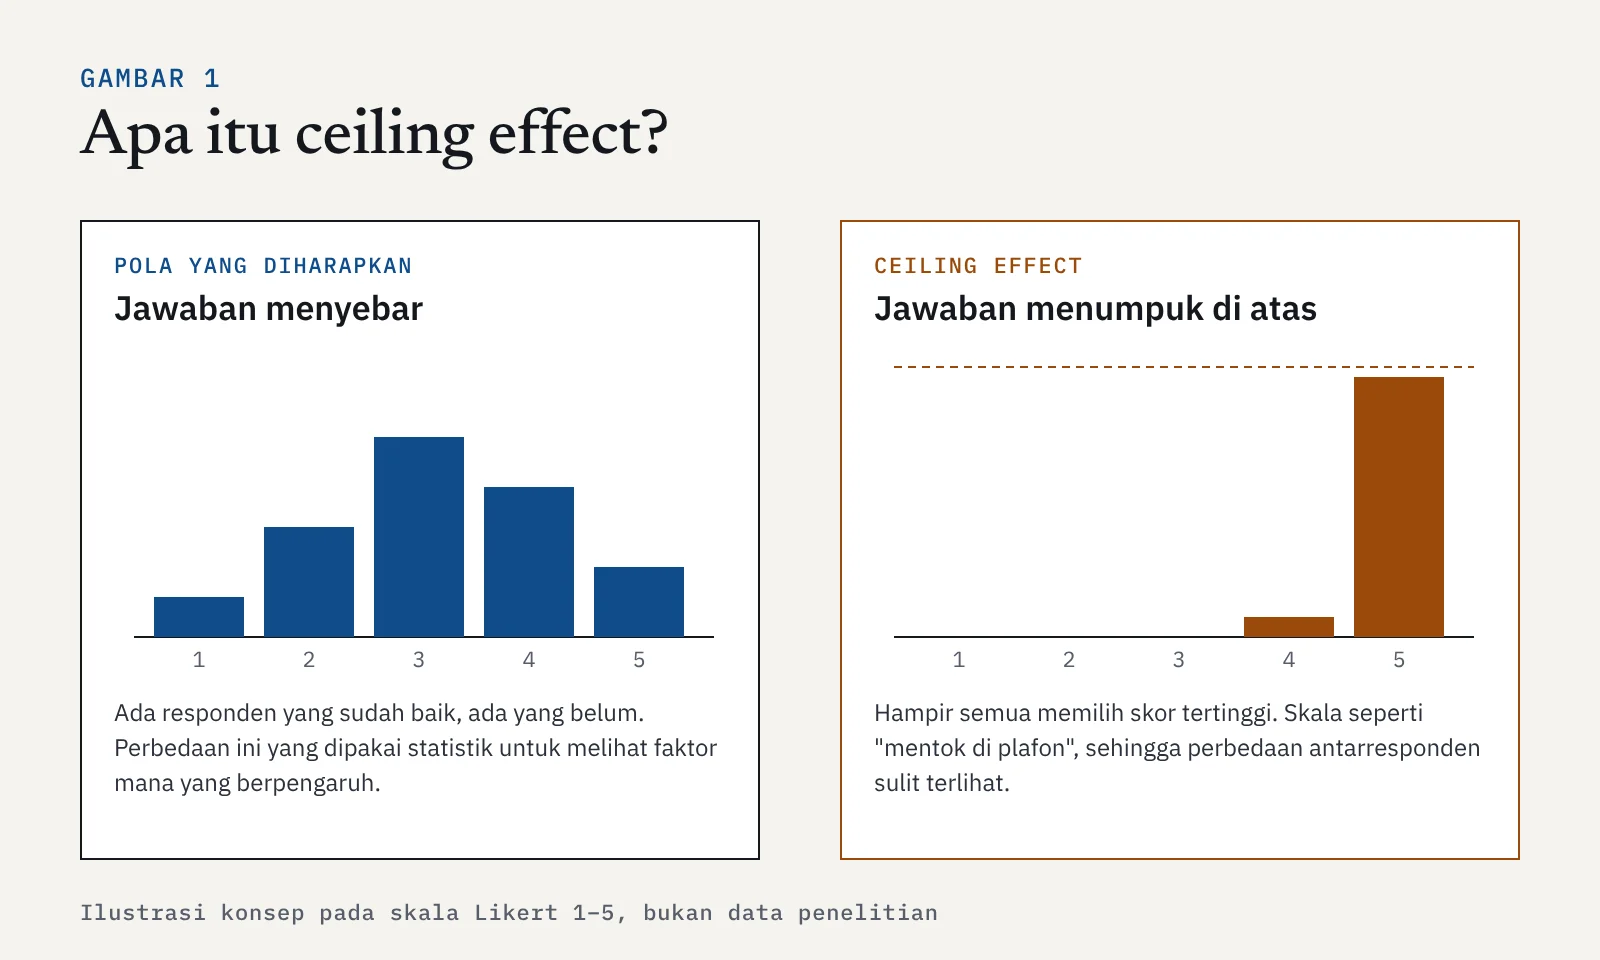
Bayangkan ujian yang terlalu mudah: hampir semua mahasiswa dapat nilai sempurna. Nilainya bagus, tetapi ujian itu gagal membedakan mana yang benar-benar paham dan mana yang tidak. Skalanya "mentok di plafon".
Hal yang sama bisa terjadi pada kuesioner berskala Likert. Kalau hampir semua responden memilih skor tertinggi, perbedaan antarresponden menjadi sangat kecil. Padahal analisis statistik seperti PLS-SEM justru bekerja dengan memanfaatkan perbedaan itu: responden yang skornya lebih tinggi pada suatu faktor, apakah juga lebih tinggi pada hasil akhirnya?
Di disertasi saya, seluruh indikator punya rata-rata yang sangat tinggi dengan rentang yang sangat sempit, dan sebarannya kecil. Gejala ini saya bahas terbuka di statistik deskriptif, di analisis IPMA, di pembahasan, dan sekali lagi di bagian keterbatasan.
Kenapa bisa terjadi? Tiga dugaan penyebab
| Penyebab | Penjelasan | Kenapa relevan di riset ini |
|---|---|---|
| Bias keinginan sosial (social desirability) | Responden cenderung menjawab sesuai apa yang dianggap "seharusnya", bukan kondisi sebenarnya | Keamanan dan kepatuhan adalah topik normatif. Siapa yang mau mengaku perusahaannya abai keamanan? |
| Self-selection | Yang bersedia mengisi survei cenderung yang memang sudah peduli dengan topiknya | Sampel non-probabilitas memungkinkan startup yang peduli keamanan lebih banyak ikut |
| Desain butir pertanyaan | Format "Apakah Anda setuju bila…" cenderung mengukur keyakinan bahwa suatu praktik itu baik, bukan seberapa sering praktik itu dijalankan | Orang mudah setuju bahwa praktik keamanan itu penting, meski belum menjalankannya |
Literatur metodologi survei sudah lama memperingatkan bahwa data self-report tentang topik yang dianggap "praktik baik" seperti keamanan, etika, dan kepatuhan rentan menghasilkan skor yang secara sistematis lebih tinggi dari kondisi sebenarnya (Podsakoff dkk., 2003). Semakin normatif topiknya, semakin besar risiko skor menumpuk di atas.
Bukti bahwa masalahnya ada di cara menjawab, bukan di lapangan
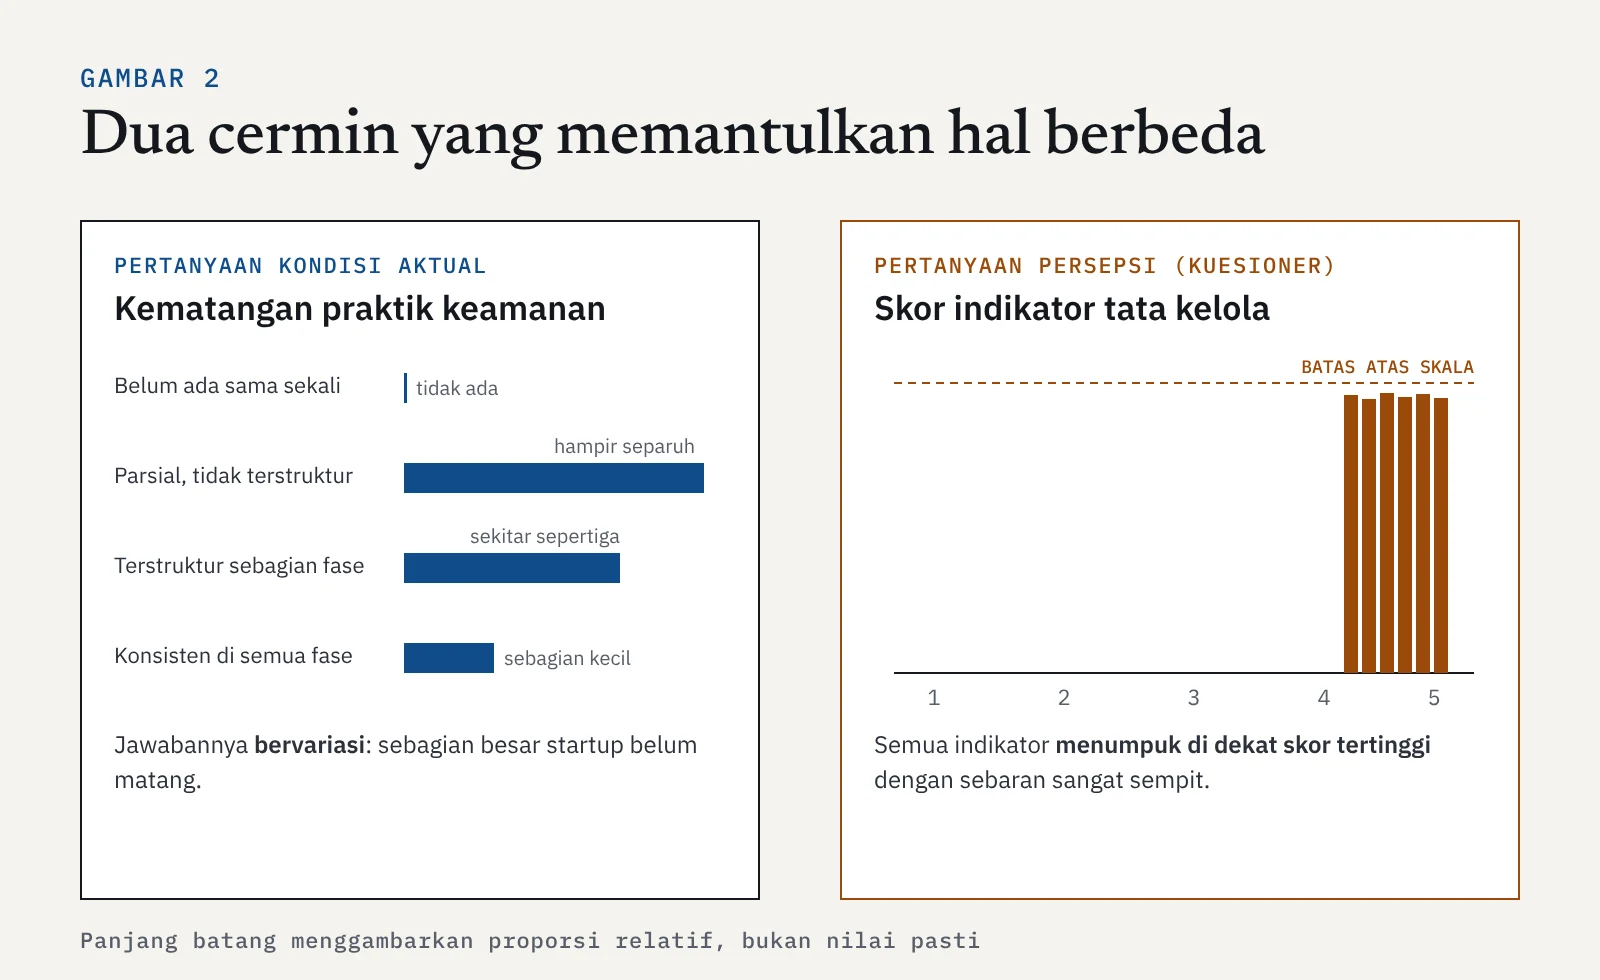
Ini bagian terpenting. Di bagian profil responden, ada satu pertanyaan tentang kondisi aktual praktik keamanan di startup mereka. Jawabannya ternyata bervariasi: tidak ada satu pun startup yang sama sekali tanpa praktik keamanan, hampir separuh praktiknya masih parsial dan tidak terstruktur, sekitar sepertiga baru terstruktur di sebagian fase, dan hanya sebagian kecil yang sudah konsisten di semua fase pengembangan.
Artinya, kondisi di lapangan tidak seragam. Sebagian besar startup masih belum matang. Kalau skor persepsi di kuesioner justru menumpuk di atas, kemungkinan besar penyebabnya adalah pola menjawab (keinginan sosial, format butir), bukan karena semua startup benar-benar sudah ideal.
Bukti kedua datang dari pilot study. Di sana penilaian dilakukan secara mendalam oleh satu informan kunci per startup, yaitu orang yang benar-benar memahami kondisi organisasinya. Hasilnya, skor efektivitas sebelum penerapan peta jalan tersebar jelas dari rendah sampai menengah, jauh lebih bervariasi daripada skor survei utama. Artinya instrumen yang sama sebenarnya mampu menangkap variasi ketika diisi secara cermat. Masalahnya lebih terkait dinamika survei berskala besar, misalnya waktu pengisian yang singkat dan keinginan tampil baik.
Apakah hubungan antarvariabel jadi rusak?
Ini pertanyaan lanjutan yang paling mungkin muncul. Ada beberapa pegangan:
- Common method bias tidak bermasalah secara statistik. Uji full collinearity dengan VIF (Kock, 2015; Hair dkk., 2022) tidak menunjukkan indikasi bias metode yang problematik. Jadi bias yang ada lebih mungkin bersifat pelaporan, yaitu menggeser skor ke atas, bukan mendistorsi struktur hubungan antarvariabel.
- Model pengukuran memenuhi kriteria. Reliabilitas dan validitas, termasuk validitas diskriminan, terpenuhi. Artinya responden tetap membedakan konstruk satu dengan yang lain, tidak sekadar menjawab "setuju" untuk semuanya secara acak.
- Peringkat kepentingan tetap tersebar jelas. Pengaruh total tiap faktor terhadap efektivitas SSDL berbeda-beda dengan urutan yang masuk akal. Yang seragam hanyalah dimensi kinerja (skor rata-rata), bukan dimensi pengaruh.
Akibatnya pada IPMA, dan bagaimana ditangani
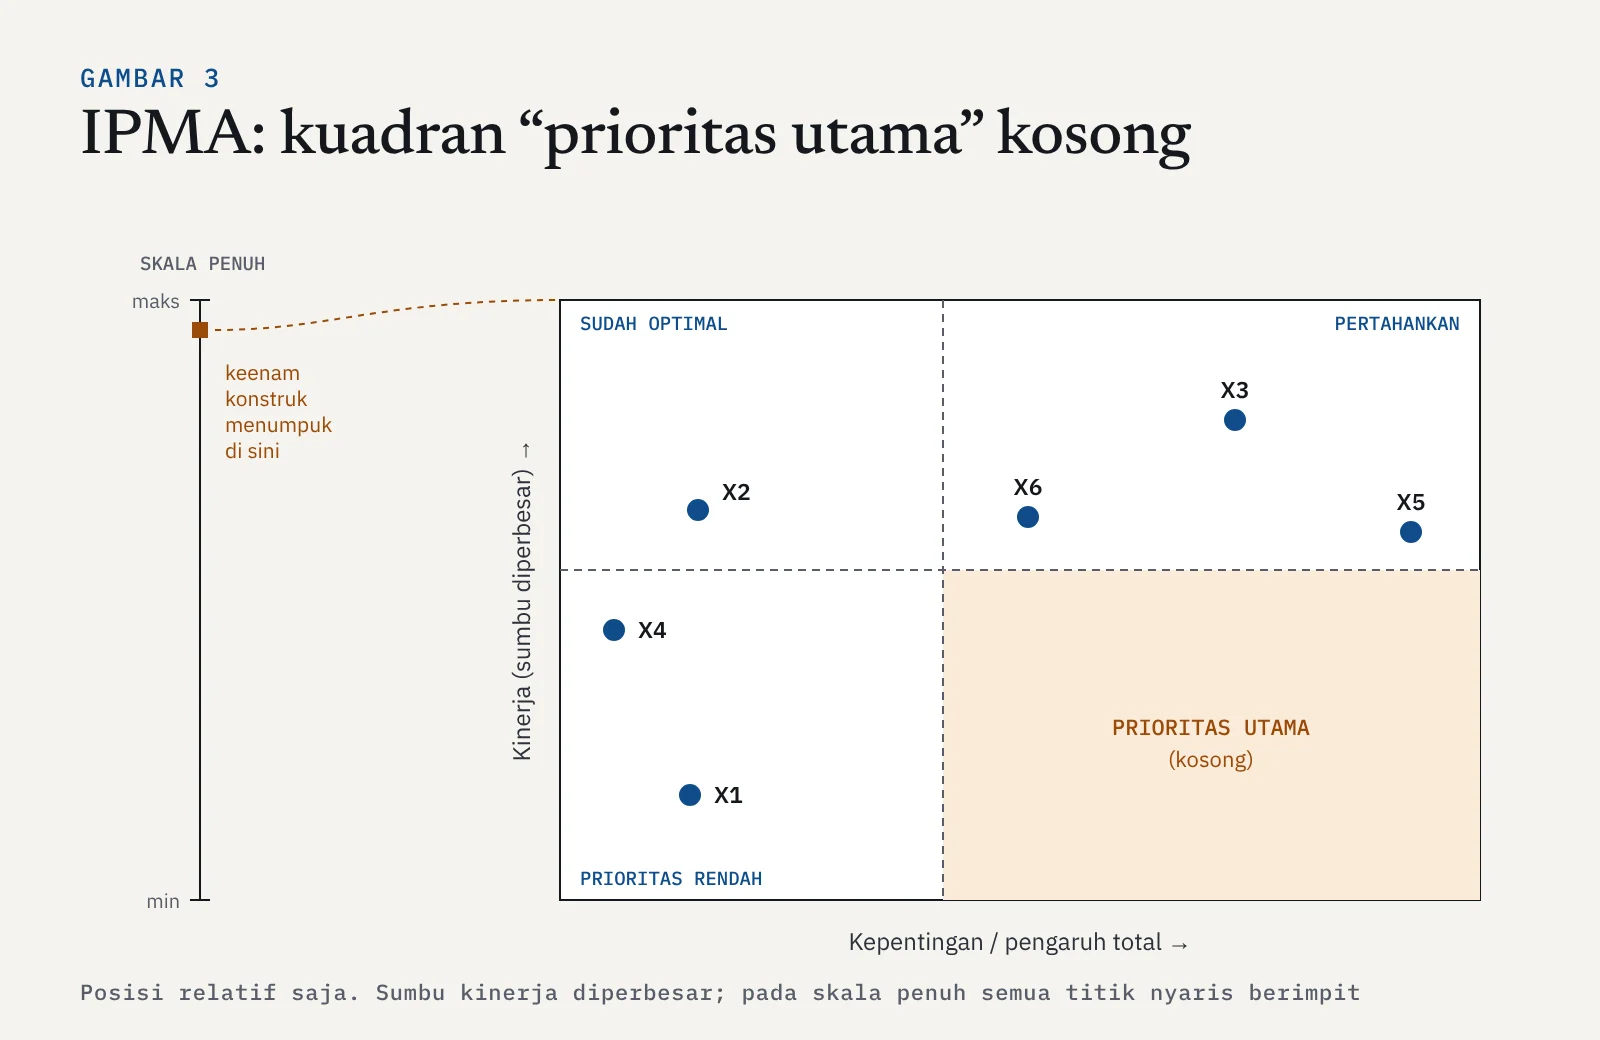
IPMA (Importance-Performance Map Analysis) memetakan tiap faktor berdasarkan dua hal: seberapa besar pengaruhnya (kepentingan) dan seberapa tinggi skornya saat ini (kinerja). Biasanya rekomendasi diambil dari kuadran "prioritas utama", yaitu faktor yang pengaruhnya besar tetapi kinerjanya masih rendah. IPMA di disertasi ini dihitung manual mengikuti prosedur Hair dkk. (2022), lalu divalidasi dengan dua cara perhitungan.
Karena skor kinerja semua faktor menumpuk di dekat batas atas, kuadran "prioritas utama" ternyata kosong. Tidak ada satu pun faktor di sana. Agar perbedaannya terlihat, sumbu kinerja bahkan harus diperbesar. Pada skala penuh, keenam titik nyaris berimpit. Selisih kepentingan beberapa faktor juga sangat tipis, sehingga batas antarkuadran rapuh.
Keputusannya: pembacaan kuadran tidak dijadikan dasar rekomendasi. Prioritas dalam model strategi diambil dari peringkat kepentingan, yaitu pengaruh total dari model struktural, yang tidak terpengaruh oleh menumpuknya skor kinerja. Skor kinerja yang tinggi juga tidak ditafsirkan sebagai bukti bahwa tata kelola keamanan startup sudah optimal.
Pelajaran dan perbaikan ke depan
| Masalah | Perbaikan yang bisa dilakukan |
|---|---|
| Butir mengukur keyakinan normatif | Ubah menjadi pertanyaan perilaku atau frekuensi, misalnya "Dalam tiga bulan terakhir, seberapa sering…" |
| Bias keinginan sosial | Perkuat jaminan anonimitas dan tambahkan butir terbalik |
| Satu sumber per responden | Gunakan lebih dari satu informan per startup, atau bukti artefak (dokumen, tiket, log review) |
| Self-selection | Gunakan kerangka sampel yang memungkinkan probability sampling |
| Satu titik waktu | Studi longitudinal untuk melihat perubahan nyata |
Di naskah, ceiling effect juga saya angkat sebagai implikasi metodologis: catatan bagi peneliti PLS-SEM di Sistem Informasi tentang risiko data self-report pada topik normatif seperti keamanan dan kepatuhan. Jadi keterbatasan ini tidak disembunyikan. Ia diubah menjadi pelajaran.
Jawaban untuk penguji
Jawaban inti, dengan pola akui → jelaskan → buktikan → tangani:
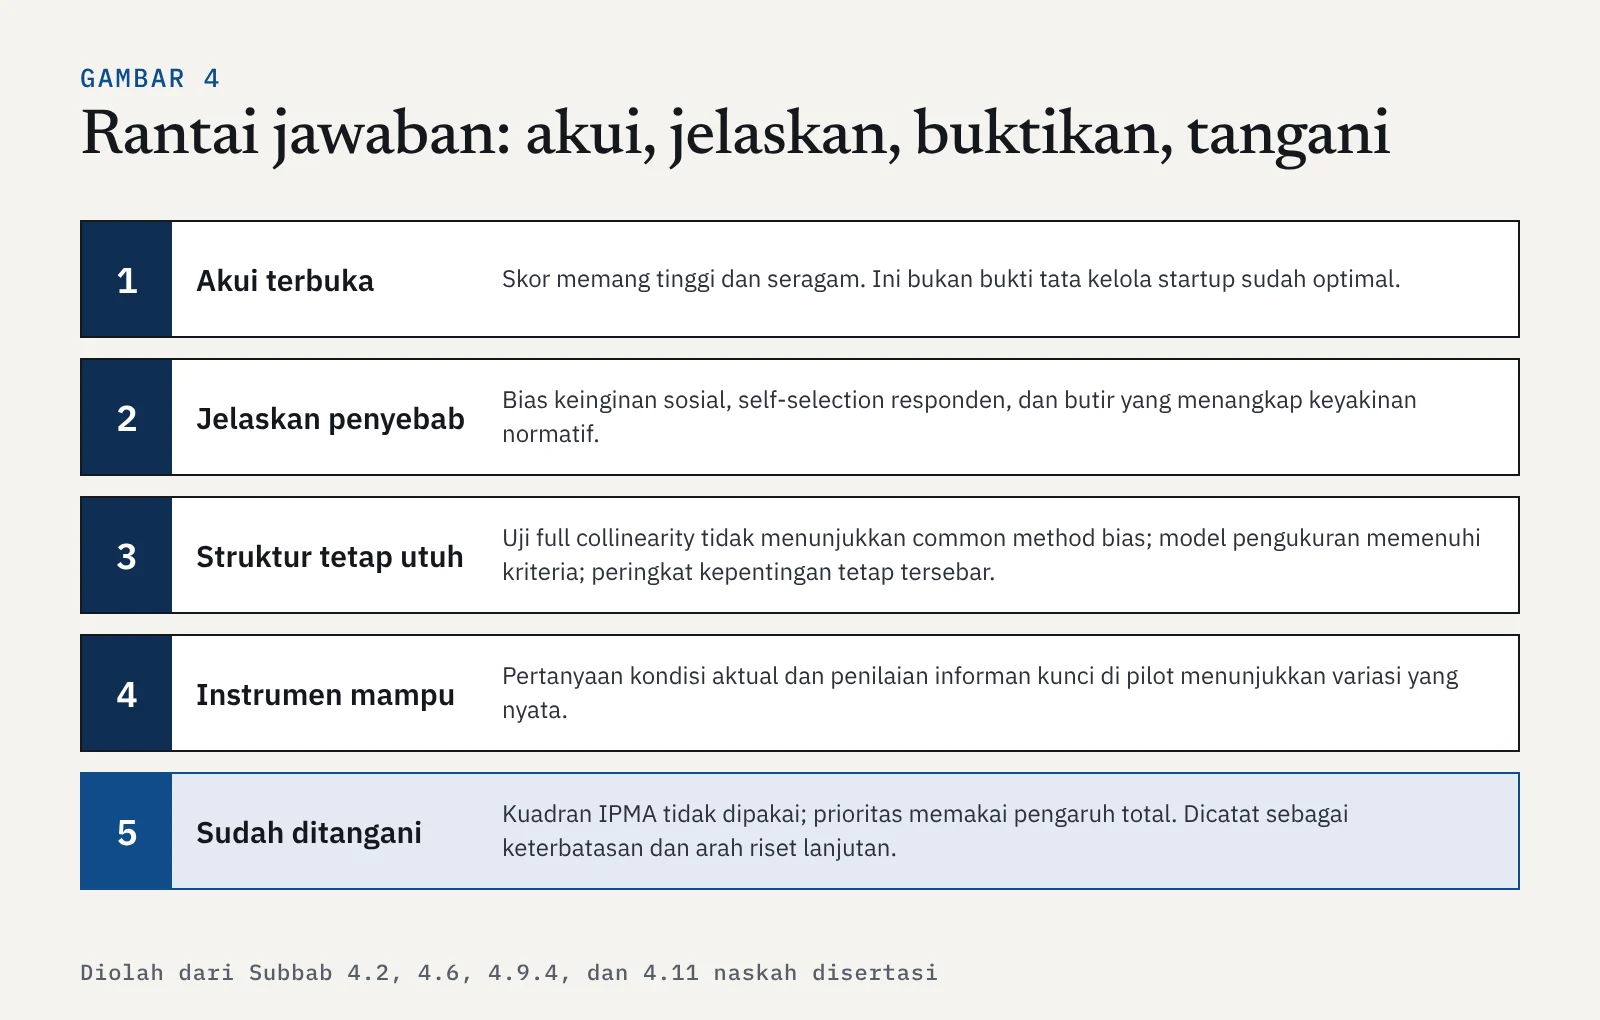
"Betul, Prof, skor seluruh indikator memang sangat tinggi dan nyaris seragam. Ini saya akui terbuka sebagai keterbatasan pertama, dan tidak saya tafsirkan sebagai bukti tata kelola startup sudah optimal. Ada tiga kemungkinan penyebab: bias keinginan sosial karena topiknya normatif, self-selection karena sampelnya non-probabilitas, dan format butir yang lebih menangkap keyakinan normatif daripada frekuensi praktik.
Ada dua alasan kenapa hasilnya tetap bisa dipegang. Pertama, struktur hubungannya tidak rusak: uji full collinearity tidak menunjukkan common method bias, model pengukuran memenuhi kriteria, dan peringkat pengaruh antarfaktor tetap tersebar jelas. Kedua, instrumennya sebenarnya mampu menangkap variasi: pertanyaan kondisi aktual menunjukkan sebagian besar startup belum matang, dan penilaian informan kunci di pilot jauh lebih bervariasi.
Konsekuensinya sudah saya tangani: kuadran IPMA tidak saya jadikan dasar rekomendasi, karena kuadran prioritas utamanya kosong. Prioritas di peta jalan saya ambil dari pengaruh total, yang tidak terpengaruh oleh menumpuknya skor. Untuk riset lanjutan, saya rekomendasikan butir berbasis perilaku, lebih dari satu informan, dan desain longitudinal."
Kalau ditanya lanjut:
- "Kalau variasinya kecil, kenapa hubungan antarvariabel tetap signifikan?" Yang dianalisis PLS-SEM adalah pola perbedaan antarresponden, bukan tinggi-rendahnya rata-rata. Selama perbedaan itu konsisten dan model pengukurannya valid, hubungan tetap bisa diuji. Yang terganggu adalah dimensi kinerja di IPMA, dan itu sudah tidak dipakai.
- "Kuesioner Anda mengukur pendapat, bukan kondisi?" Sebagian betul, dan sudah saya akui di naskah. Karena itu kesimpulan saya batasi sebagai hubungan berbasis persepsi pada satu titik waktu, lalu saya lengkapi dengan bukti lapangan dari pilot yang memakai penilaian lebih mendalam.
- "Kenapa tidak diulang saja surveinya?" Pola ini baru terlihat jelas setelah data terkumpul dan dianalisis. Langkah yang bertanggung jawab adalah melaporkannya secara terbuka, menyesuaikan cara membaca hasil, dan menjadikannya rekomendasi desain bagi penelitian berikutnya.
Kalimat kunci untuk diingat: "Skor yang tinggi tidak saya baca sebagai kondisi yang baik. Saya membaca pola pengaruhnya, bukan tinggi skornya."
Referensi
- Hair, J. F., Hult, G. T. M., Ringle, C. M., & Sarstedt, M. (2022). A primer on partial least squares structural equation modeling (PLS-SEM) (3rd ed.). Sage.
- Kock, N. (2015). Common method bias in PLS-SEM: A full collinearity assessment approach. International Journal of e-Collaboration, 11(4), 1–10. https://doi.org/10.4018/ijec.2015100101
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
Pembahasan tiap bagian disertasi lainnya bisa kamu temukan di kategori Riset.